האם אנדרואידים חולמים על מילונים ממוחשבים?
מילים דיגיטליות 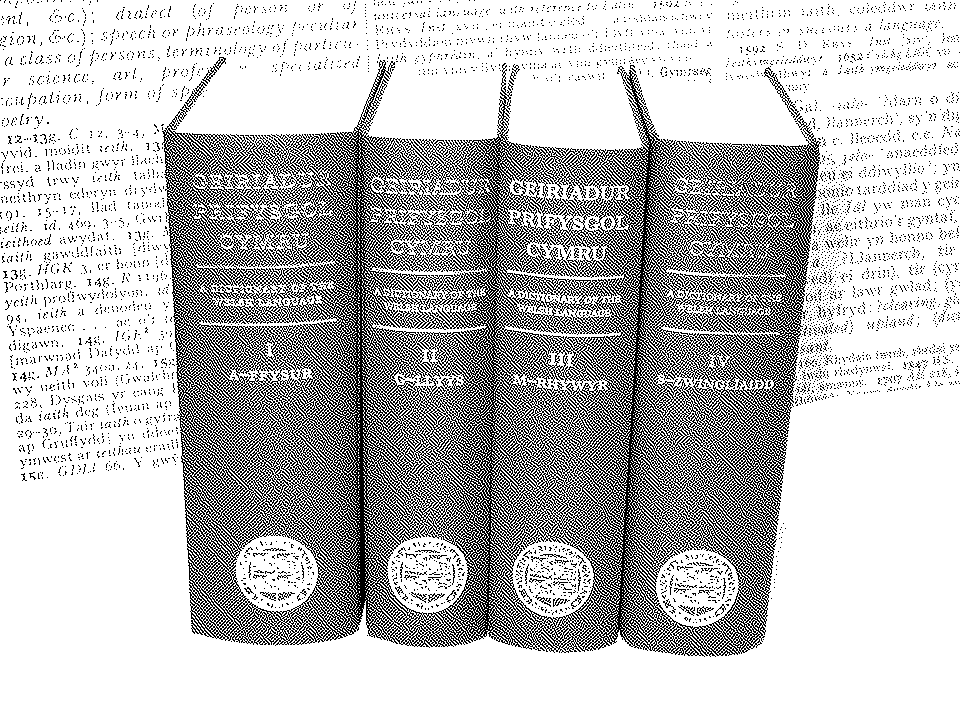 סיפור קצר על איך חילצתי גרסה שימושית של המילון הוולשי הגדול, ה־Geiriadur Prifysgol Cymru, ובאיזה מהמורות טכניות נתקלתי בדרך.
מצב העמוד: ירוק־עד
תוכן עניינים
הדף שלפניך מבוסס על השרשור הזה בפדיוורס.
הבעיה
„מילון אוניברסיטת וויילס” (Geiriadur Prifysgol Cymru) הוא המילון הגדול של השפה הוולשית: תחשבו על ה־Oxford English Dictionary, רק לוולשית. הוא עם כיסוי רחב, וכולל מידע מתוארך על היקרויות ואטימולוגיה. יופי של דבר, באמת, רק מה חבל: הגישה אליו היא דרך ממשק אונליין מצ׳וקמק, דרך המהדורה המודפסת () ודרך אפליקציה מצ׳וקמקת. זה אומר שאי אפשר אפילו להריץ חיפושים על גוף הערכים, אלא רק על ה־headwords. זה לא עסק. יש כאן מאגר מידע שניוני רחב ועמוק ומוקפד, אבל עם צוואר בקבוק מגביל מאוד מבחינה טכנית. כשהייתי בכנס קלטולוגי לפני כמה שנים היה שם דוכן של המילון וניגשתי לדבר איתן על האפשרות להנגיש את המידע בצורה גולמית בפורמט פתוח כך שהוא יוכל לשמש חוקרות באופן חופשי, אבל לא היתה הענות מהצד השני: סוגשל מיושנות ומקובעות בשילוב עם ישיבה „דרקונית”הכניסו כאן חידוד על הדרקון האדום. על גבי אוצר (של מילים). אמנם טוב שכן השאירו אפשרות לקרוא במילון באופן ממוחשב פר מילה שיודעות מראש, אבל זה מאוד חלקי וחסר.
הפתרון
החלטתי לעשות מעשה. מה עשיתי?
מַגְרֵד
בהתחלה חשבתי לכתוב scraper שיוריד מילה־מילה מהמילון המקוון. זה רעיון בעייתי גם כי הוא יעמיס על השרתים שם (ובאיזשהו שלב יש סיכוי שיחסמו אותי), גם כי זה עלול לקחת המון זמן (המון מילים + זמן תגובה לא משהו) וגם כי זה עלול להיות מאוד לא יעיל במקום: לא מדובר בעמודי HTML פשוטים, אלא בגיבוב JavaScript מכוער ומגושם שטוען דברים דינמית. הורדה פשוטה לפי URL היא לא אופציה, ונראה היה שאין ברירה אלא להשתמש בספריה שמדמה דפדפן או בדפדפן מקוצץ־ראש (headless) כדי להוריד את הנתונים.
אז זאת לא אופציה מוצלחת.
אפליקציה לאנדרואיד
מצד שני…
יש הרי את האפליקציה, ולמרבה השמחה יש בה אפשרות להוריד את המילון לשימוש לא מקוון. אמרתי לעצמי שאנסה לחלץ את הנתונים משם. אז התקנתי את האפליקציה, הורדתי מתוכה את המילון ו… שיט, איפה זה שמר את זה ואיך אפשר לגשת לקובץ שהורד? יש אפליקציות ששומרות מידע במקום משותף כללי ונגישכמו AnkiDroid לדוגמה, ששומרת את עיקר הנתונים של מאגר החפיסות בשטח אחסון משותף שאאל״ט תואם אנקי למחשב. לא זוכרת אם אפשר לבחור לשמור בשטח הלא משותף או לא, וזה לא משנה לענייננו., אבל רובן שומרות במקום שלא נגיש מחוץ להן, לדוגמה על ידי אפליקציית מנהל קבצים.
מחסום לא עביר? חלילה! הפעלתי את ה־developer options, חיברתי את הטלפון למחשב עם USB ובעזרת ADBמערכת שמאפשרת לעשות דברים בטלפון בעזרת המחשב. מיועדת נומינלית לדיבוג (זה ה־D בר״ת Android Debug Bridge), אבל יש לזה הרבה שימושים נוספים. הורדתי את הקבצים של האפליקציה:
adb backup -noapk dk.emp.gpcעבד כמו קסם, עכשיו יש לי במחשב תת־ספריה שבה יש קובץ בשם המופלא database-large.bas, שכלל מה שנראה כג׳יבריש מוחלט בלי שום קצה חוט.
מחסום בלתי עביר? חלילה! גם אם זה לא פורמט סטנדרטי, הרי האפליקציה יודעת איכשהו לקרוא אותו. נערוך לה תשאול ידידותי… הורדתי את ה־APK (קובץ חבילה של אפליקציה באנדרואיד) מ־APKPureרק אחרי זה חשבתי שבטח אפשר לחלץ APK מהטלפון בעזת ADB, בטח פשוט בלי ה־-noapk…), פרשתי אותו (זה ZIP אחרי הכל) וחיטתי בו קצת. לא מצאתי שום דבר מועיל במישרין. הדברים היחידים שהיו קריאים כטקסט ורלוונטיים היו כל משני שטויות של הממשק, אבל שום קוד רלוונטי.
מחסום בלתי עביר? חלילה! א·נשים טובות כתבו דקומפיילר בשם JADX שמאפשר בדיוק את מה שהייתי צריכה. טיול קצר וממוקד עם חיפוש בעץ הספריות גילה תת־ספריה בשם database ובתוכה נצץ קובץ בשם Decode.javaכאן נכנס האפקט הזה . מבט בתוכו גילה כל מני שורות שנראות ככה:
int i2 = (int) ((97 * j) % 251);»
זה „צופן” XORהדבר היחיד הטוב שלמדתי ב„הכשרה” שלי בקריירה הצבאית הכפויה והקצרה שלי (מהגיוס ועד שהבנתי שהדבר הנכון הוא לצאת והצלחתי לצאת עברו סה״כ כשמונה חודשים) זה היה צפני XOR בקורס של חיל הקשר. גם אם זאת שיטת הצפנה קלה לפיצוח, אי אפשר לחלוק שיש בה אלגנטיות.. למה העולם כל כך מטומטם? . כאילו, למה זה טוב בכלל „להצפין” את מסד הנתונים, ואם כבר הייתן כל כך חשדניסטיות כדי להצפין אותו, למה בשיטה כזאת מצ׳וקמקה? תעלומות ומסתורין…
כבר אפשר לראות את האור בקצה המנהרה , אבל יש לנו פוקנציית decode שמקבלת מפתח ואין לנו מפתח.
מחסום בלתי עביר? חלילה! מתישהו בקוד הרי יש קריאה לפונקציה הזאת, נכון? אפשר לחפש את הקריאה הזאת ולראות מה הארגומנטים של הפונקציה ואז לעטות קפוצ׳ון ברוב הדר והוד ו„לפרוץ” את ההצפנה. אוי, טאטע…. אז חיפשתי (rg "Decode.decode") ומהמפתח הוא 5120. מאוד מקורי. עכשיו כל מה שנותר הוא לכתוב את הפונקציה decode מחדש בשפה סבירה והגיונית (פייתון) ולקוות לטוב. וכן יצא טוב! יש נתונים בפורמט קריא!
הידד! \(@ ̄∇ ̄@)/
הסיפור קרוב לסופו, אבל עדיין יש טיפה עבודה לעשות. נראה שזה איזה פורמט פנימי מכוער ולא משהו סטנדרטי או נפוץ. כל הנתונים הרלוונטיים של המילון מרוכזים בטקסט פשוט בלי מטא־דאטה, כשכל ערך מופיע עם תגים במשהו שנראה XML־י. סביר שיש לא·נשים שכותבות את המילון משהו גולמי יותר שממנו מופק הקובץ הזה וכולל מבנה מורכב יותר של מסד נתונים עם טבלאות שמחלקות כל ערך לחלקים השונים שלו, אבל לצרכים שלי התוצאה המופקת מספיקה. אז יש לנו את המילון כטקסט פשוט, אבל לפניו ואחריו יש המון ג׳יבריש בינארי שכנראה כולל את ההפניות וההזחות כדי למצוא את המילים בתוך מסד הנתונים. מחקתי את הג׳יבריש משני הצדדים, אבל נורא לא נוח שהכל בשורות ארוכות מדי שתוקעות את NeoVim. בשביל מה האלים בראו את הכלים היוניקסיים אם לא בשביל דברים כאלה? חיתוך של שבירות השורות שכן היו (tr -d '\n') ושבירת שורה לפני כל headword, שמסומנת בתג head (sed 's/<head>/\n&/g') עשו את העבודה, ועכשיו סוף כל סוף יש לי קובץ שאפשר לעבוד איתו! הללויה!
כל העסק הזה לקח כמה שעות, אבל היה מעניין ומלמד וכיפי. זה מטומטם שהיה צריך להערים את כל הקשיים האלה אבל לפחות אפשר היה ללמוד מזה משהו וזה היה אתגר נחמד, ואולי גם יצא כאן טקסט מעניין לקריאה.
המטרה
למה בכלל רציתי שיהיה לי את המילון בפורמט נגיש וחפיש (לא רק לפי headwords באופן מגביל)? בשביל מחקר מגניב (לדעתי) שאני רוצה לעשות ולפרסם. מה שאני רוצה לבחון זה את האופנים שאילות לקסיקליות עם עיצורים שפתיים תחיליים מתנהגות בוולשית מבחינה פונולוגית (צלילית) לאורך המאות. למה דווקא החתך של שפתיים ותחיליים? אוֹ, מעולה ששאלתן! הסיבה היא שיש מערכת מורכבת של התאמות ושינויים וניתוחים־מחדש שקשורים לסביבה התחילית: מה קביל בה מבחינה פונוטקטית (התכונות של התארגנות הצלילים בשפה: מה יכול להופיע איפה וביחד עם מה וכד׳), מה קורה כששואלות מילים שלא קומפטיביליות עם המערכת הפונולוגית של שפת היעד ואיך כל זה נמצא באינטראקציה עם התכונה המגניבה שיש בשפות קלטיות, של מוטציות עיצוריות תחיליות (קידוד של מידע דקדוקי על ידי הבדלים עיצוריים בראש רכיבים; היה על זה פעם שרשור כאן בפדיוורס). אני יכולה להתחיל לפרט על זה באופן מלא, אבל אז זה יהיה לכתוב את הרקע למאמר לפני שעשיתי את המחקר. אז בקצרה, עיצור /v/ תחילי לא אפשרי באופן רגיל במילים וולשיות אצליות (أصليَات). מה קורה כשנשאלת מילה עם הצליל הזה בפוזיציה תחילית? זו בדיוק השאלה, וממה שראיתי נראה שהתשובה לה תלויה בזמן: אפשר לשאול עם /b/, אפשר עם /m/ ואפשר עקרונית להשאיר את הזרות ולשאול עם /v/ תחילי. מה שמסבך^wממרכב את העניין הוא של־/b/, ל־/m/ ול־/v/ יש קשרים מעניינים תחת מוטציות: /b/ ו־/m/ מתאחדים ל־/v/ תחת ריכוך ול־/m/ תחת מוטציה אפית, כך שעקרונית אם אתן נתקלות במילה עם מוטציה אי־אפשר לדעת א־פריורי אם אתן לא מכירות את המילה האם היא במקור עם /b/ או עם /v/ (או במקרה של זה שיש מולכן /v/, אם היא שמרה על הזרות שלה והצורה המילונית שלה מתחילה ב־/v/ גם בלי ריכוך). הפוטנציאל לבלבול נעשה גדול יותר במילים זרות, מעצם זה שהן פחות מוּכּרות כשהן נשאלות.
הזכרתי את העניין בקצרה בהרצאה שהעברתי לפני כחודשבקישור יש הפניה למצגת ולמלל של ההרצאה, כך שאם זה מעניין אתכן תוכלו לעיין גם אם לא לאזנן..
אז איך הגישה החופשית למילון עוזרת? גם זו שאלה טובה. בעזרת המילון ובזכות העובדה שיש בו מידע אטימולוגי ורישום של ההיקרויות של המילה בטקסטים אני רוצה ליצור מיפוי של מה נשאל איך ומתי, ולראות אם יש מגמות מובהקות. כשיהיו לי נתונים אלמד איך לנתח אותם מבחינה סטטיסטית (זאת לקונה בידע שלי; פתיר) ואיך להציג את המגמות (או את העדרן; אני לא יודעת מראש) בצורה נגישה וברורה ויפה ומשכנעת. אולי איזה סוג של גרף/אינפוגרפיקה; אבדוק איך טיפלו בסוגיות דומות א·נשים שעסקו בוויזואליזציה של נתונים, ובפרט מה יש ל־Edward Tufte תבורכנה־ידיו לומר בעניין.
איזה נתונים אאסוף מהמילון? נראה לי שהשדות הקריטיים הם:
- צורה בוולשית.
- צורה בשפה ממנה נשאלה המילה.
- מה השפה ממנה נעשתה השאילה (donor language).
- מתי התיעוד המוקדם ביותר.התיעוד המאוחר ביותר לא מאוד עוזר עם המילון הזה מההיכרות שלי, כי הוא חסר וכבר מצאתי הרבה פעמים מילים שמופיעות בטקסטים מהמאה ה־20 עם רישום מאוחר ביותר במילון ממאות שעברו. לא נראה לי שיש נסיון להביא תיעודים מאוחרים באופן מסודר, אבל הקצה השני כן חשוב ולמיטב ידיעתי גם די מוקפד: אם מופיע תאריך ראשון סביר שזאת באמת הפעם הראשונה שאנחנו נתקלות במילה הזאת, או שלכל הפחות זה לא מאוד רחוק מבחינת התקופה.
- לאיזה צליל נשאל הצליל המקורי.
- מה היה הצליל המקורי בתקופה ובמקום שבו הוא נשאל.
זהו בגדול. זה בעצם מיפוי על פני זמן של זוגות של צלילים (X, Y) כאשר X נשאל מ־Y.